查看接口
查看接口
兼容 OpenAI SDK,支持 deepseek-chat / deepseek-reasoner 与 128K 硬盘前缀缓存。
与合订 OpenAI SDK 兼容 硬盘前缀缓存
DeepSeek api开放平台
DeepSeek api开放平台
官方通道工程
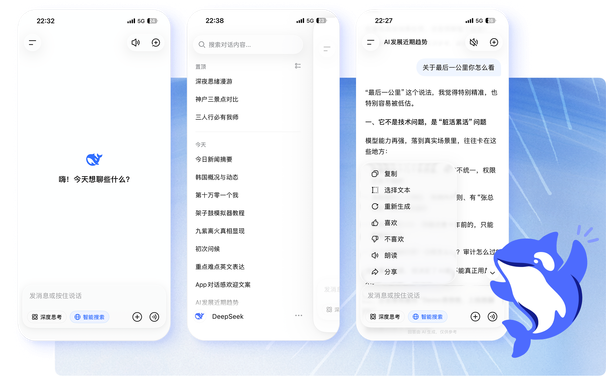
浏览器打开即可对话。可以接着追问,也可以贴代码、公式和长文。上下文 128K。接口示例在帮助页。
685B
双端点同源满血权重
128K
硬盘缓存上下文窗口
92.6%
Harness 勘误复测分
〔第抽展 OpenAI SDK 调用〕
deepseek-reasoner
如何用 Python 调用 DeepSeek R1 并读取思考链草稿?
from openai import OpenAI
client = OpenAI(
    api_key="YOUR_KEY",
    base_url="https://api.deepseek.com"
)
res = client.chat.completions.create(
    model="deepseek-reasoner",
    messages=[{"role": "user", "content": "证明素数有无穷多个"}]
)
print(res.choices[0].message.reasoning_content)
print(res.choices[0].message.content)
重复长前缀自动计入
prompt_cache_hit_tokens。为什么用 DeepSeek
从云端 API 调用到私有化部署的完整记录
模型与上下文
本地硬件门槛与 Zero-shot 提示词工程
上篇:DeepSeek本地部署Ollama硬件配置要求
内网或单机环境可直接执行 ollama run deepseek-r1:7b。7B/8B 蒸馏模型需 8–12GB 显存;14B/32B 需 16–24GB 显存;70B 需双卡 48GB 以上;671B/685B 满血版建议多节点 FP8 集群配合 vLLM 或 SGLang。
下篇:DeepSeek R1思维链提示词工程指南
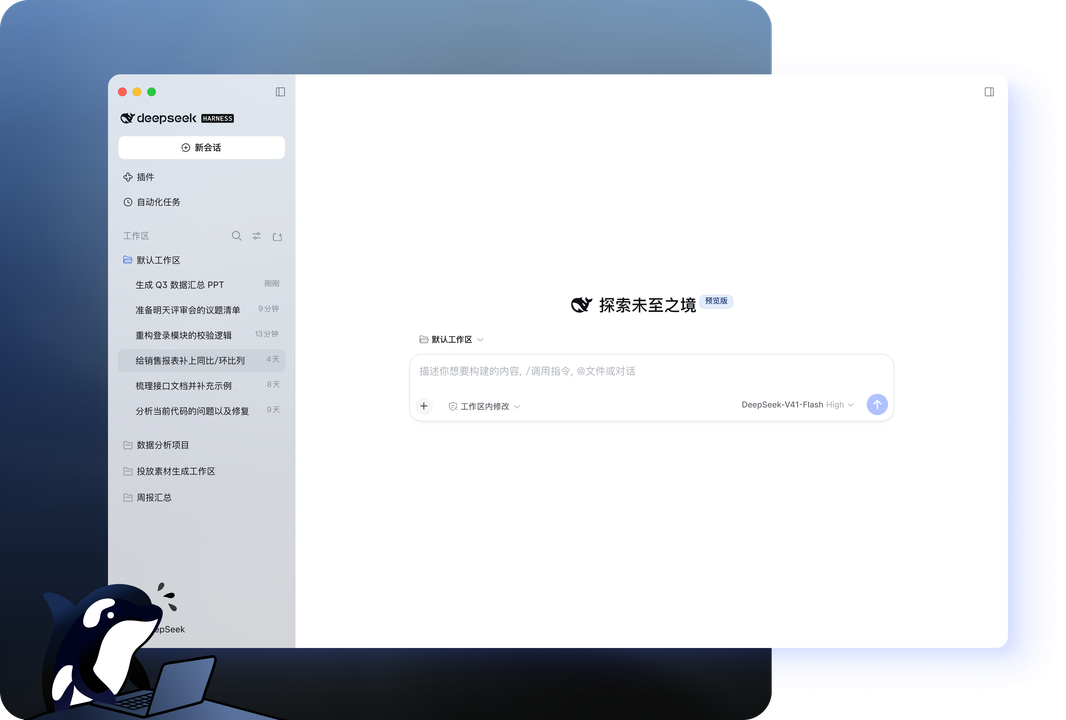
调用 deepseek-reasoner 时宜用 Zero-shot 直接写明目标、输入约束与输出 Schema,不必在提示词中人为拼接分步思考套话,以免干扰模型内置的 reasoning_content 推导链。
常见用法
企业知识库、代码流水线、工具编排与回归勘误
开发者入口
Harness
Harness
固定随机种子 · MATH-500 (92.6%) / LiveCodeBench / Schema 校验| 勘误编号 | 评测科目 | 原发谬误现象 | Harness 勘误校定方案 | 复核结果 |
|---|---|---|---|---|
| 01 | MATH-500 数论与组合 | 模运算与容斥原理在大数边界漏减交集项 | R1 草稿阶段强制小规模枚举验证公式闭合性 | 92.6% Pass@1 |
| 02 | 多语言算法合成 | 图遍历未标记访问顺序导致稠密图超时 | 入队即标记 visited,并在草稿核算最坏时间复杂度 | 回归全通过 |
| 03 | API JSON 结构化输出 | 长文本抽取时偶发转义引号未闭合 | 解码器层绑定 JSON 语法状态机,阻断非法 token | 100% 合法解析 |
| 04 | 128K 前缀缓存对齐 | 动态时间戳置于系统提示词首部导致缓存失效 | 静态长文档置前、动态变量置后,确保前缀命中 | 缓存命中率 >90% |
使用反馈
来自后端 运维与评测团队的
查看接口
赵跋
“单张 24G 显卡照着跑 Ollama 32B 蒸馏版 内网离线写脚本和审配置非常流畅。”
孙跋
Harness
吴跋
工程词条