【首简 · DeepSeek官网总纲】
阅读官网三章 →
DeepSeek - 探索未至之境。685B MoE 满血基座(激活 37B),支持 128K 长上下文。
DeepSeek R1深度思考模型
官方通道
官方通道
官方人工智能
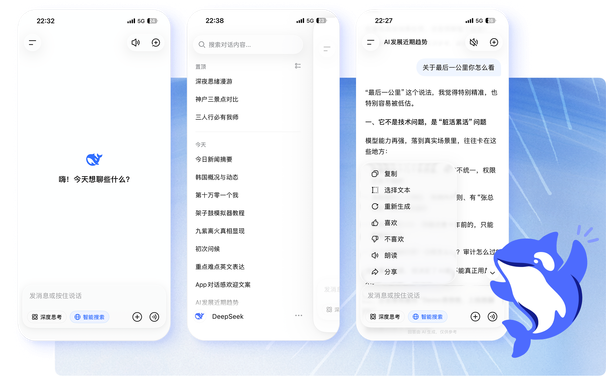
浏览器打开即可对话。可以接着追问,也可以贴代码、公式和长文。上下文 128K。接口示例在帮助页。
685B
MoE 满血参数(激活37B)
128K
单次上下文窗口
92.6%
MATH-500 实测准确率
打开网页版
DeepSeek R1
用 Python 写一个并查集(Union-Find),带路径压缩和按秩合并。
思考简记:使用 parent 数组与 rank 数组,find 递归时直接挂到根节点。
class DSU:
    def __init__(self, n: int):
        self.p = list(range(n))
        self.r = [0] * n
    def find(self, x: int) -> int:
        if self.p[x] != x:
            self.p[x] = self.find(self.p[x])
        return self.p[x]
单次操作均摊复杂度为 O(α(n))。
如果还要统计每个连通块的大小,应该怎么改?
为什么用 DeepSeek
查看接口
模型与上下文
上篇记 685B 混合专家稀疏激活,下篇记 128K 硬盘前缀缓存
上篇:685B MoE 与 MLA 多头潜在注意力
DeepSeek(亦写 Deep Seek)基座总参数量 685B,单次词元生成仅激活 37B 专家权重;配合 MLA 潜在注意力显著压缩 KV 显存占用,兼顾满血推理精度与流式响应速度。
下篇 128K 容量与自动前缀缓存
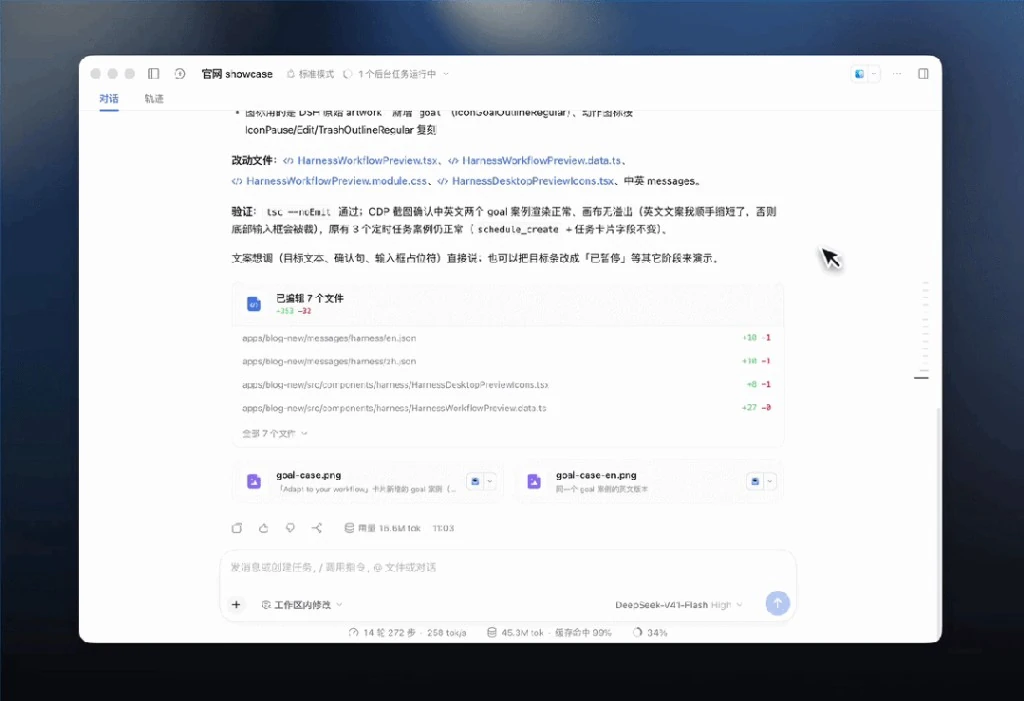
网页版与开放接口共享 128K 上下文窗口。接口调用重复长系统提示词或知识库前缀时,自动触发分布式硬盘缓存,命中部分按极低单价结算。
常见用法
日常研发、算学、文献与结构化抽取
开发者入口
开放 API、开源权重与 Harness 勘误记录
DeepSeek api开放平台
替换 base_url 即可接入 OpenAI SDK,支持 SSE 流式输出、Function Calling 与 128K 硬盘缓存。
Ollama 本地与满血集群
7B/8B 蒸馏版单卡 8–12GB 显存即可运行;685B 满血版支持 vLLM / SGLang 多节点部署。
DeepSeek Harness 勘误准绳
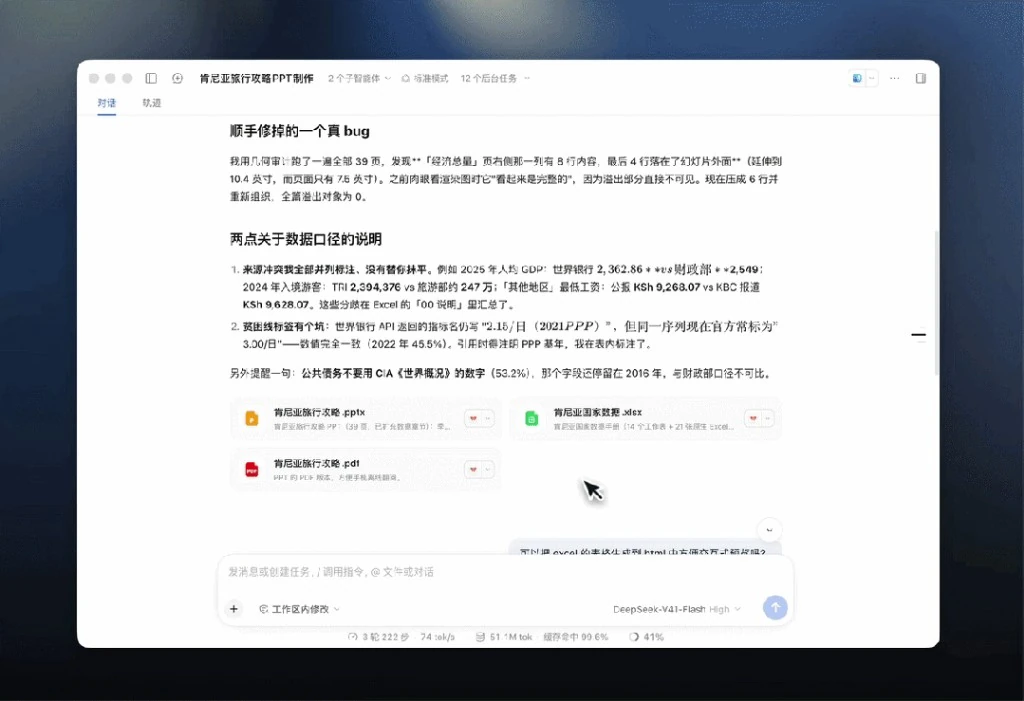
在集中校勘模型在数学、代码与 JSON 格式化中的常见偏差,锁死种子回归复核。
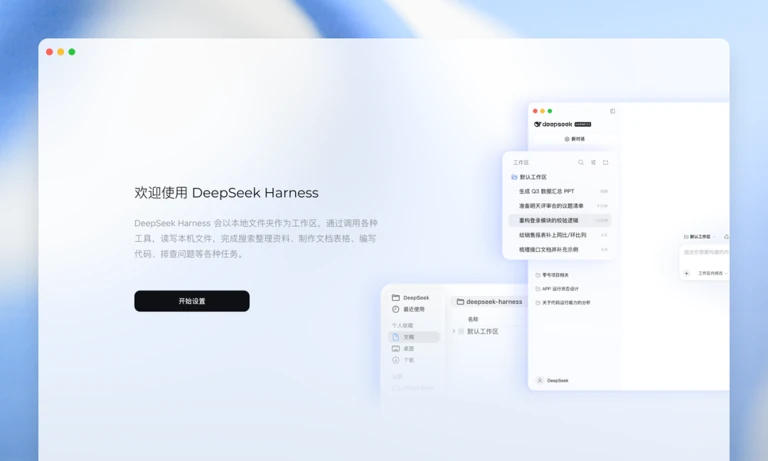
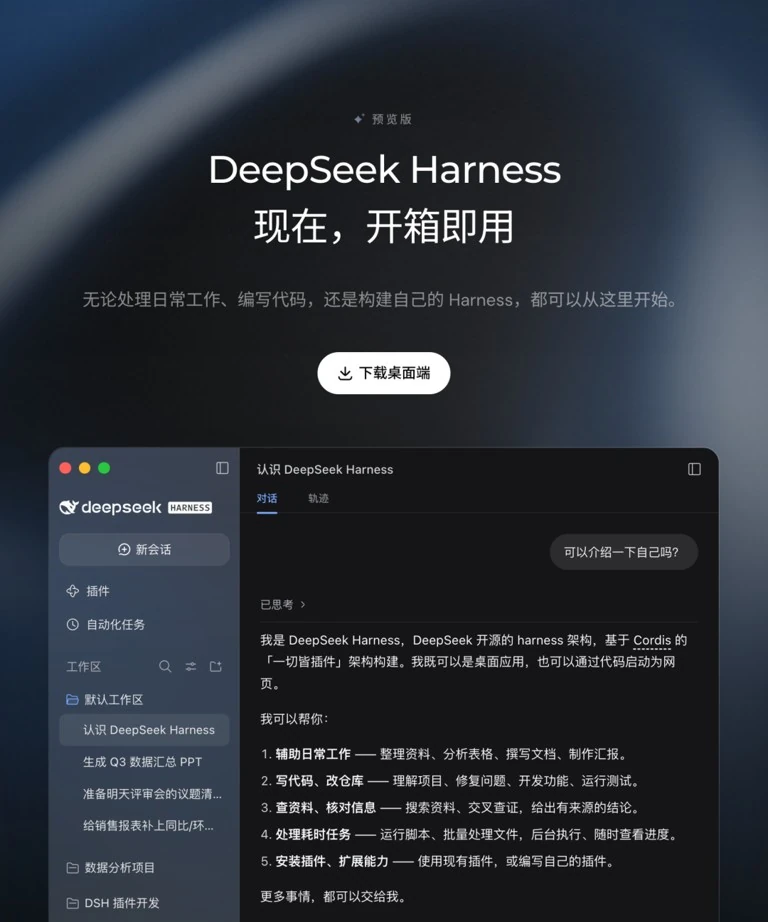
Harness
校勘基准:MATH-500 (92.6%) / LiveCodeBench / JSON Schema| 简号 | 原发易错项(未校前) | Harness 勘误修正策略(已合入 R1 / V3) | 复测结果 |
|---|---|---|---|
| 勘误一 | 二分查找与滑动窗口闭区间右端偶发越界 | 在 R1 思维链草稿阶段强制代入空数组、单元素与重复值做反例自检 | 通过(Pass@1 提升) |
| 勘误二 | 长链不等式缩放时跳步导致正负号反转 | Harness 锁死固定随机种子,对 MATH-500 逐题核验中间引理符号 | 92.6% 达标 |
| 勘误三 | 复杂嵌套 JSON 偶发多出 Markdown 解释尾注 | 开放平台启用严格 Schema 语法树约束,剥离非结构化冗余字符 | 100% 合法 JSON |
使用反馈
来自算法、法务与私有化团队的实测记录
“把深度思考打开后,复杂图论题会先把反例排查写在前面,线上代码一次性通过率高了很多。”
张跋
“128K 窗口能把整套中英文招投标文件一次读完,前后责任条款比对非常顺手。”
李跋
“每次升级提示词前先跑一遍的 Harness 勘误题集,JSON 格式和数学得分一目了然。”
王跋
关联词条(点击直达)